
给鸿蒙 App 增加遗留字符集编解码能力 —— charset_converter 的鸿蒙使用指南
给鸿蒙 App 增加遗留字符集编解码能力 —— charset_converter 的鸿蒙使用指南
对接老系统、解析历史数据、往只认 GBK 的网关发报文——Dart 内置的编解码器只有 UTF-8、Latin-1、ASCII,遇到 GBK、Big5、Shift_JIS 这类遗留字符集就得靠平台原生能力。charset_converter 把编码转换交给各系统自带的 ICU/Charset 设施,零第三方依赖地补齐了这个缺口,鸿蒙侧已有适配版本:https://atomgit.com/oh-flutter/charset_converter。读完本文,你能在鸿蒙 Flutter 应用里引入它,用与其他平台完全相同的代码完成任意字符集的编码、解码、可用性探测,并知道怎么选字符集、怎么处理编不了的字符。
一、最终运行效果
适配仓库的 example 启动后自动运行 13 项验证,效果如下。主界面为结果列表,顶部统计卡显示 availableCharsets 返回 232 个字符集、checkAvailability 对四个真实字符集判 true、对不存在的名字判 false:
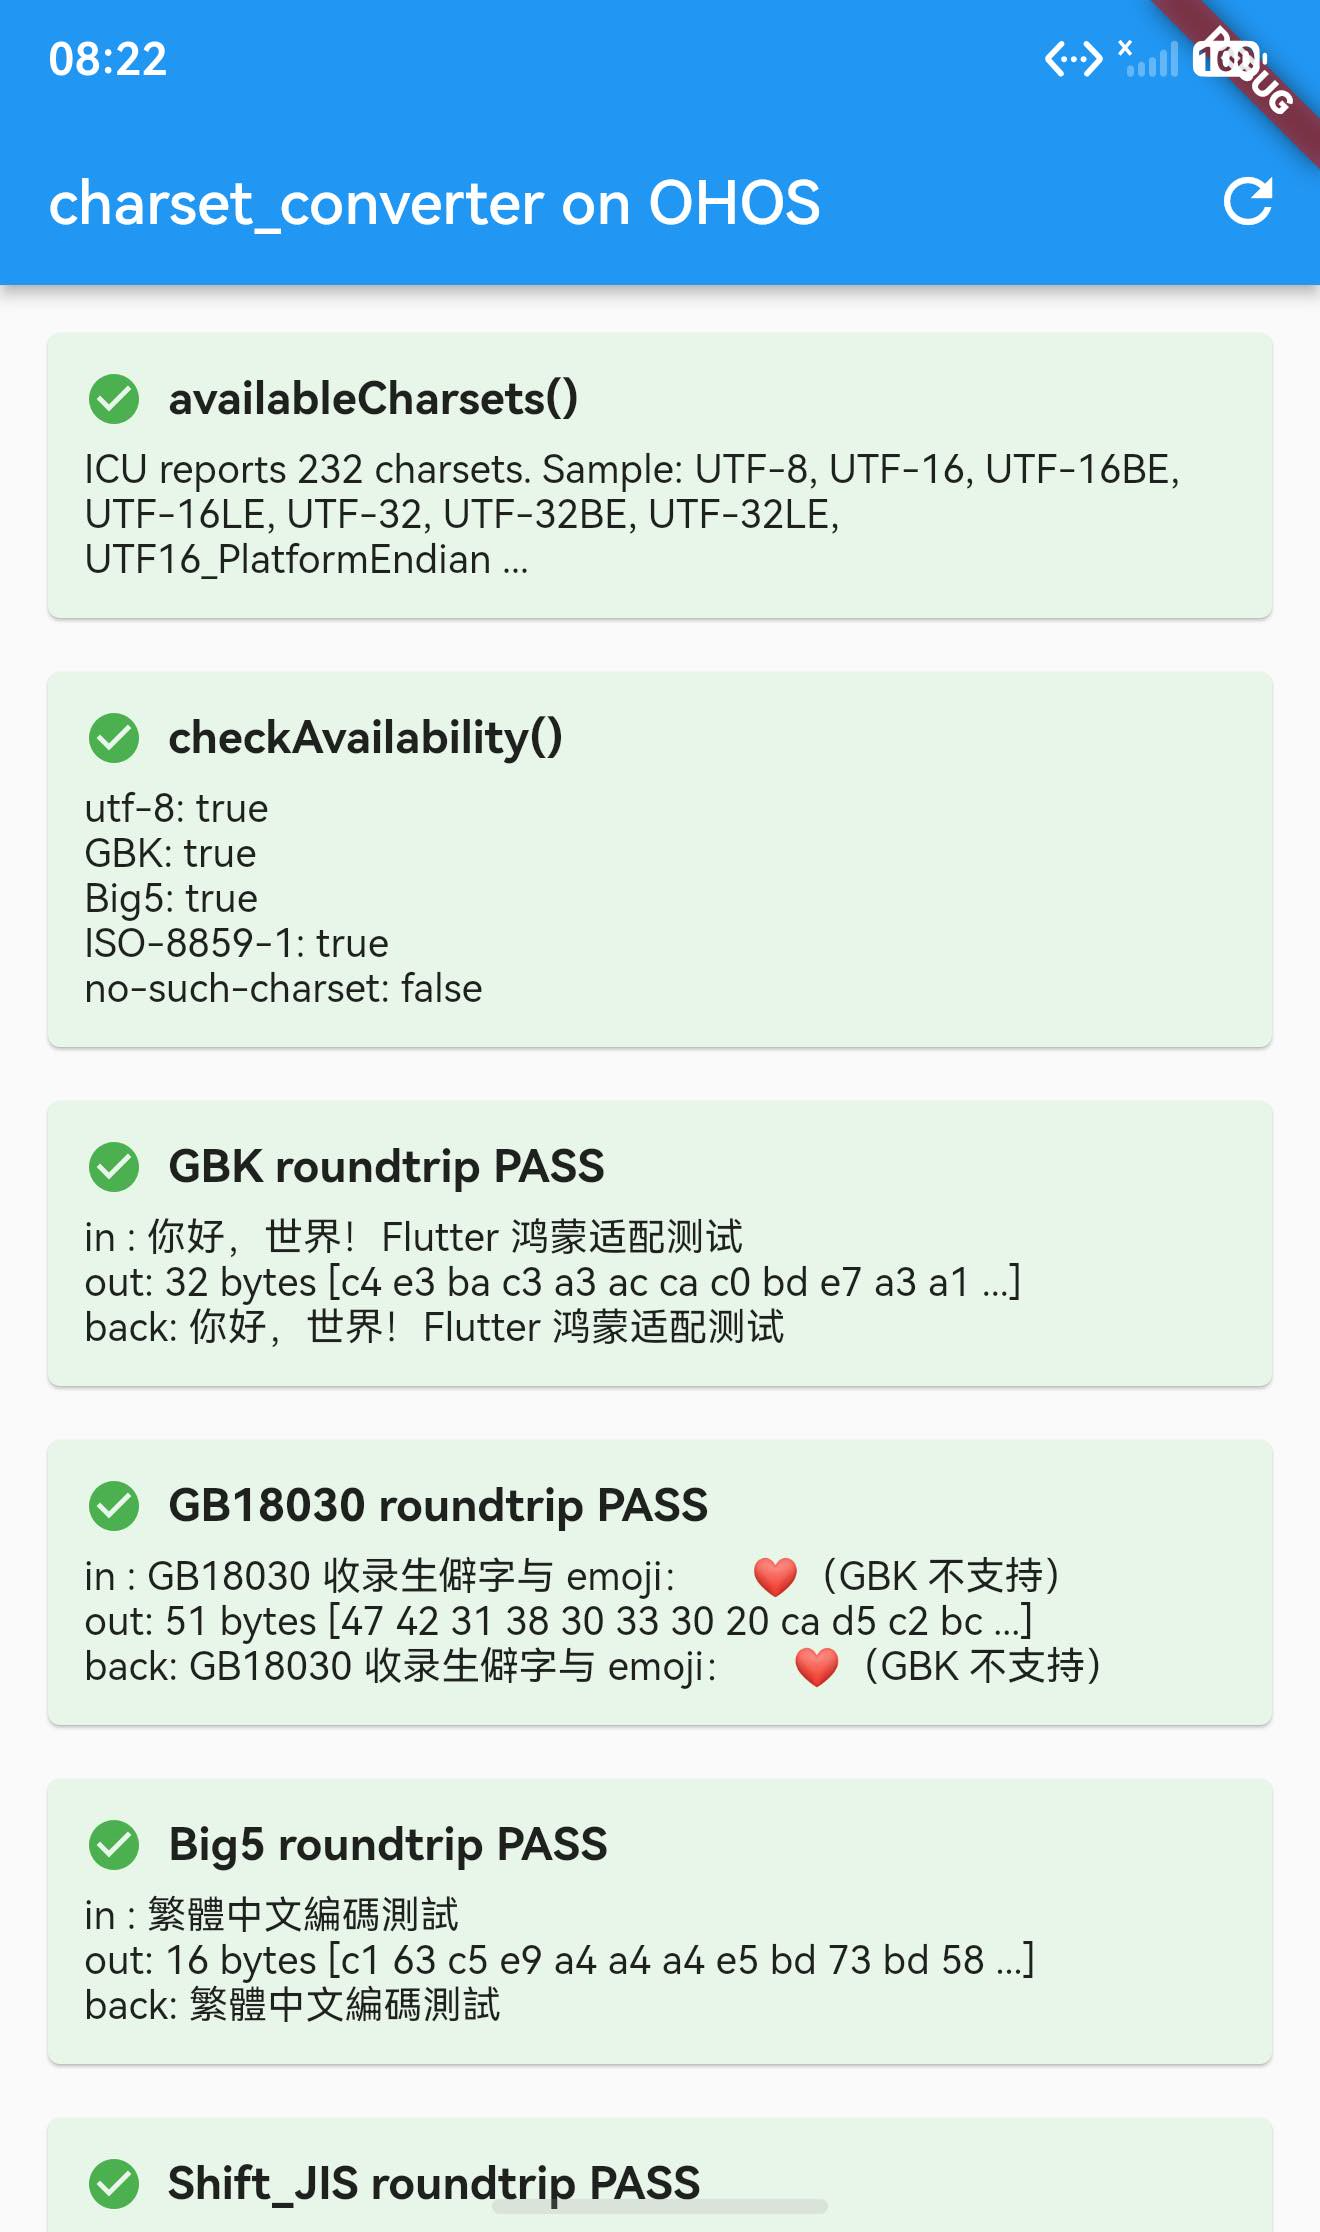
图一:example 启动即自动跑完全部验证,每项用例显示输入、输出字节与回环结果
中日韩字符集的 round-trip 结果,GBK、GB18030、Big5、Shift_JIS、EUC-KR 全部 PASS,其中 GB18030 用例包含 GBK 编不了的生僻字与 emoji:
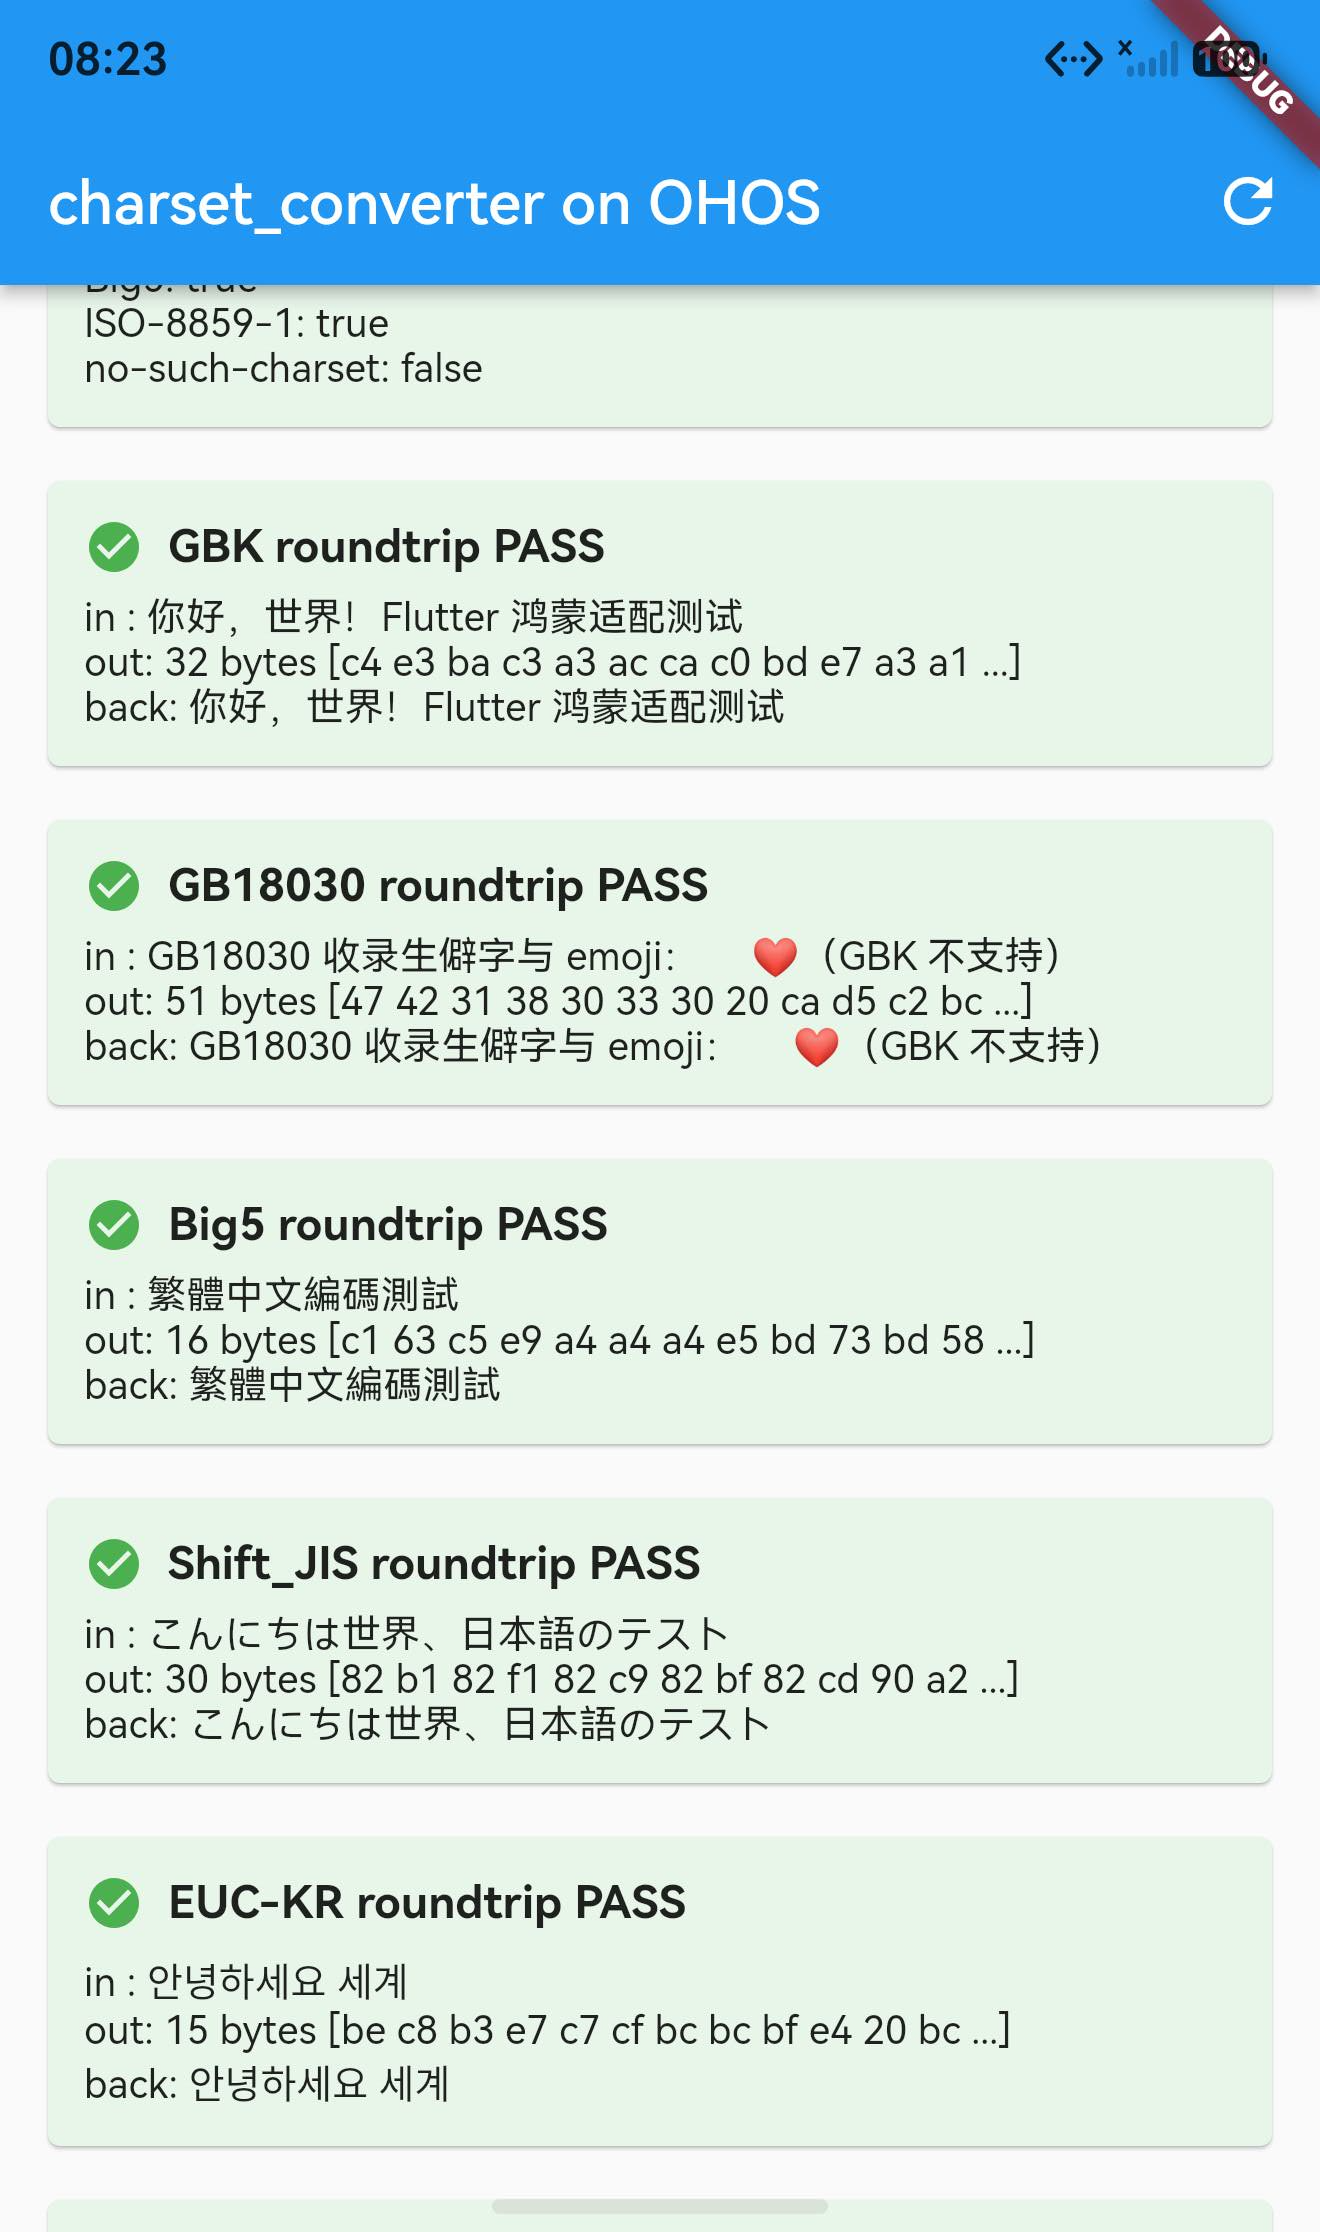
图二:中日韩字符集编码后字节序与解码回环结果
错误处理演示,对不存在的字符集调用 encode 会抛出带 ICU 错误名的 PlatformException,应用不崩溃:
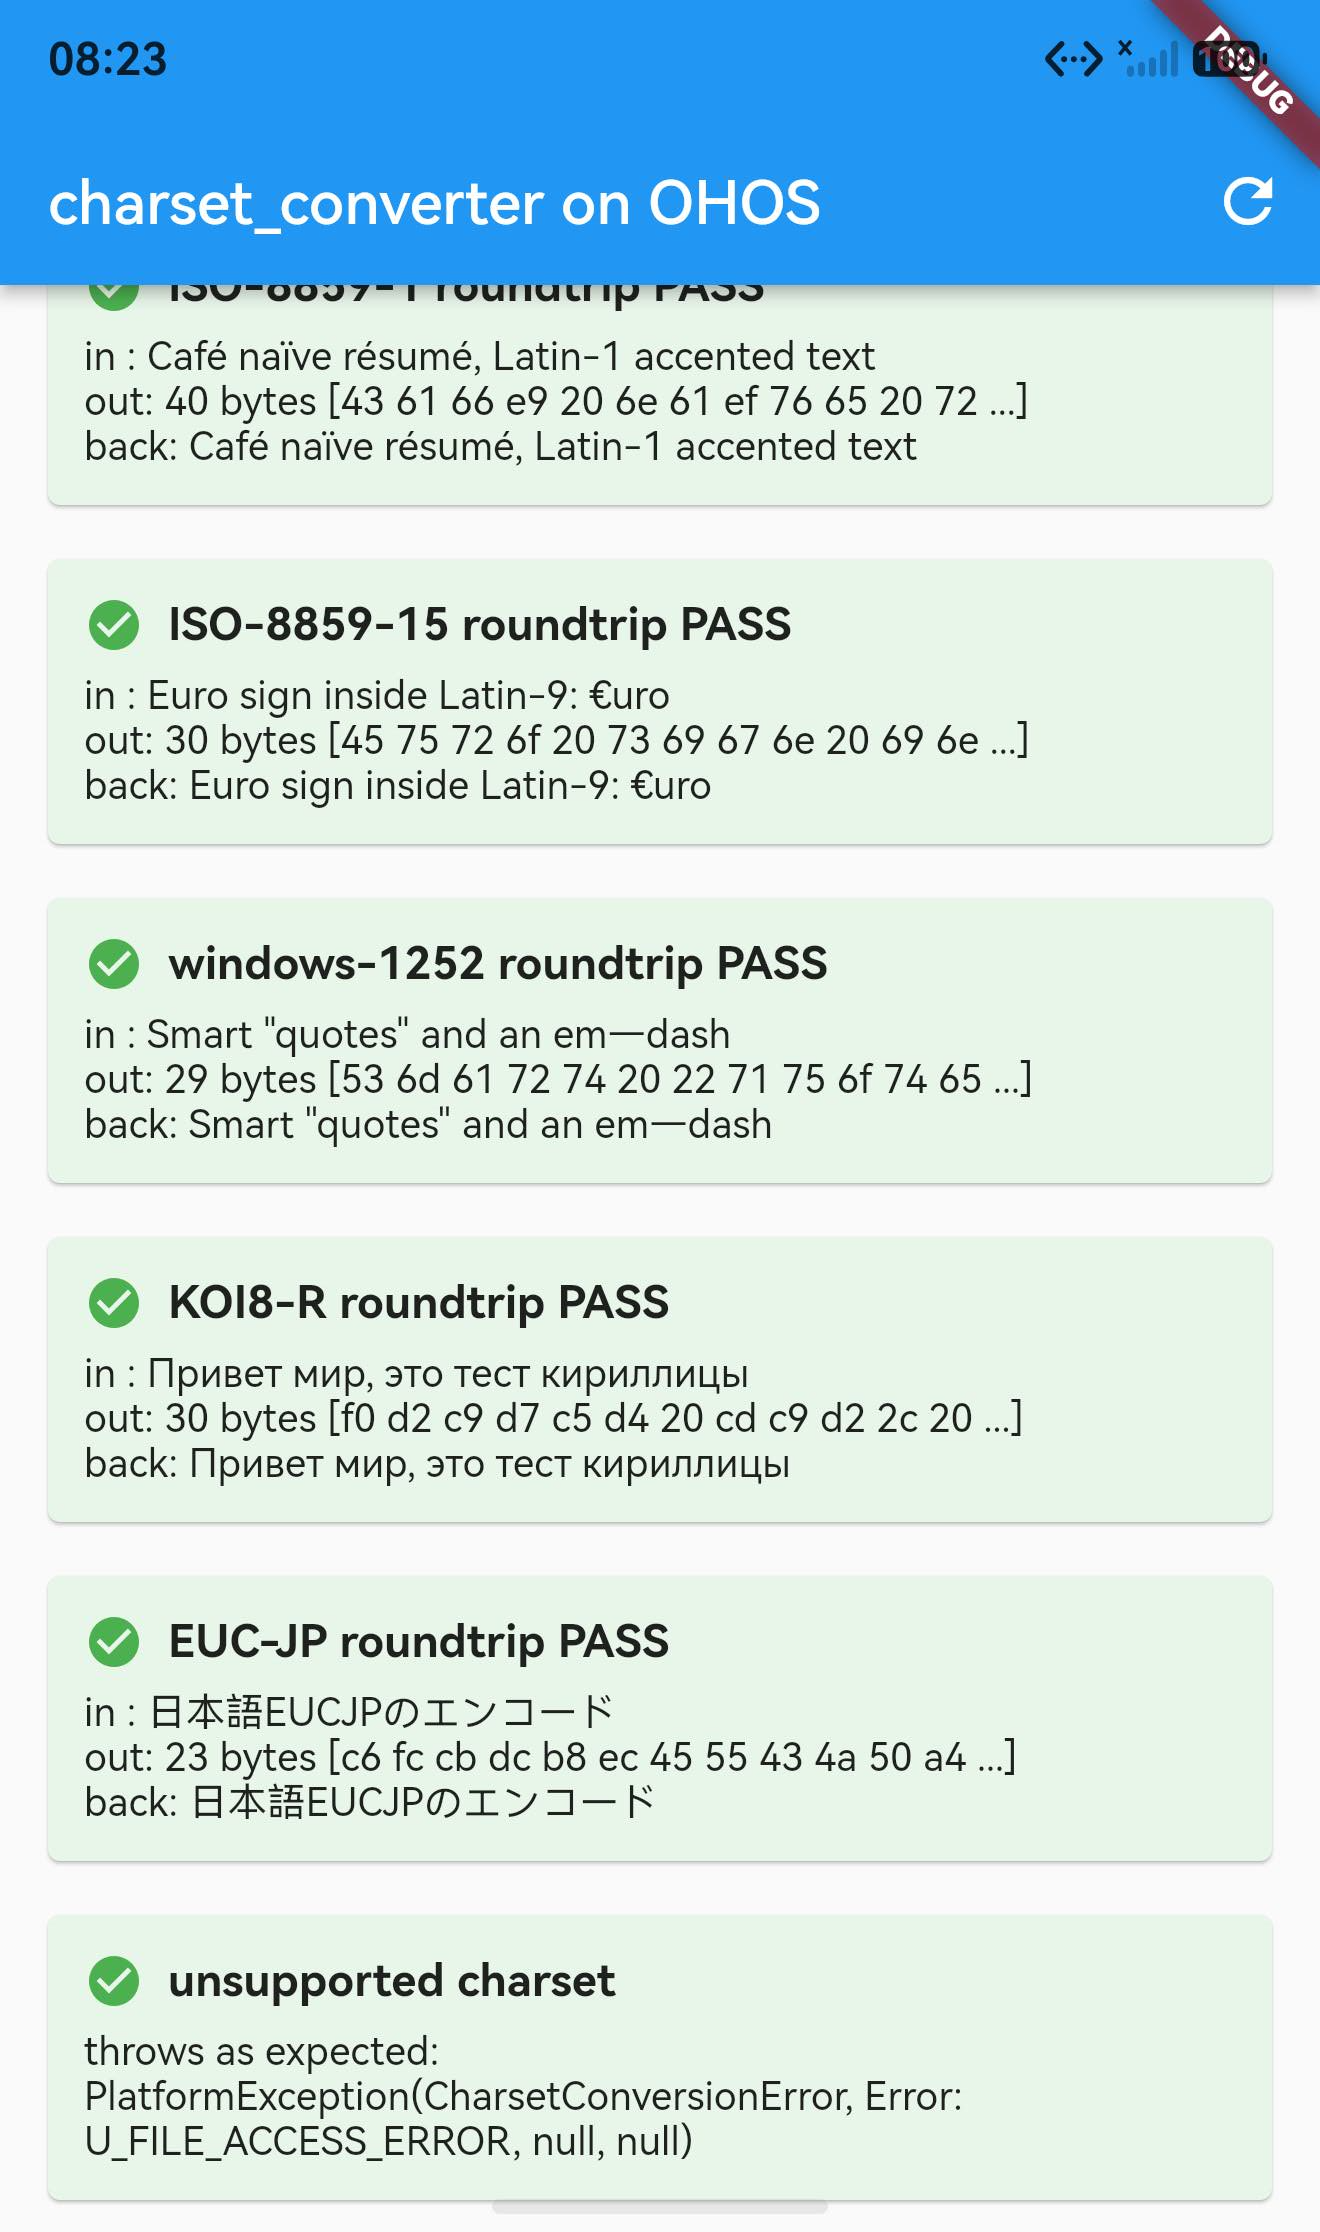
图三:不支持的字符集正确抛异常,错误信息可直接定位原因
二、charset_converter 是什么
charset_converter 是 pub.dev 上的字符集/编码转换插件(作者 pr0gramista,MIT 协议,上游 2.4.0),特点是"用平台自带的转换器":Android 走 java.nio.charset.Charset,iOS/macOS 走 Core Foundation,Linux 走 iconv,因此包体不携带任何编解码数据。核心接口四个:encode(文本 → 指定字符集字节)、decode(字节 → 文本)、checkAvailability(探测字符集是否可用)、availableCharsets(列出全部可用字符集)。本仓库已完成 OpenHarmony 适配(基于系统 ICU4C 的 NAPI 实现,TAG:2.4.0-ohos-1.0.0-beta.1),Dart 接口与各平台完全一致,适配过程见姊妹篇《charset_converter 的鸿蒙适配教程》。
三、环境准备
鸿蒙 Flutter 开发环境(ohos 版 SDK、DevEco Studio、模拟器或真机)的搭建步骤,官方指南已写得很细,直接照做:
本文实测环境:
| 项 | 版本 |
|---|---|
| Flutter(ohos 版) | 3.41.10-ohos-1.0.1 |
| DevEco Studio | 26.0.0.821 |
| 编译 SDK | HarmonyOS 26.0.0(OpenHarmony API 26) |
| 实测设备 | DevEco 模拟器 emulator 7.0.0.105(OpenHarmony API 26) |
运行示例需要一台已完成签名配置的鸿蒙设备(模拟器或真机均可),并确认 hdc list targets 能看到它。
四、引入依赖
自建工程用 git 依赖并锁定 TAG:
dependencies:
  charset_converter:
    git:
      url: https://atomgit.com/oh-flutter/charset_converter.git
      # ref: 根据下方表格选择不同框架适配的TAG版本
      ref: 2.4.0-ohos-1.0.0-beta.1
然后执行:
flutter pub get
TAG 与框架版本对照:
| Flutter 框架版本 | TAG 名称 | 分支名 |
|---|---|---|
| 3.41 | 2.4.0-ohos-1.0.0-beta.1 | feat/ohos_charset_converter_2.4.0 |
兼容性说明:以上 TAG 在 stable 引擎(3.41.10-ohos-1.0.1)上实测通过;若使用 canary 引擎,宿主工程的 compatibleSdkVersion 需按引擎要求调整到 API 26。
五、代码接入
5.1 encode:文本编码为目标字符集字节
把 UTF-8 文本编码成目标字符集的字节序列,典型场景是往只认老编码的系统提交数据:
import 'dart:typed_data';
import 'package:charset_converter/charset_converter.dart';

final Uint8List bytes = await CharsetConverter.encode('GBK', '你好,世界');
// bytes => [0xC4, 0xE3, 0xBA, 0xC3, ...]
参数 charset 为字符集名(支持 ICU 别名,gb2312、utf-8、cp1252 都能识别),data 为待编码文本;返回 Future<Uint8List>。目标字符集编不了的字符会被替换字符填充(见第八节 Q3),字符集名不支持时抛 PlatformException。
5.2 decode:字节解码回文本
把指定字符集的字节序列解码成 UTF-8 文本,典型场景是解析历史数据或外部设备上报的报文:
final String text = await CharsetConverter.decode('GBK', bytes);
// text => '你好,世界'
参数 data 为原始字节;返回 Future<String>。字节序列与字符集不匹配时不会报错而是尽力转换,来源编码不明确时建议配合 round-trip 校验(第八节 Q4)。
5.3 checkAvailability:探测字符集是否可用
在真正编解码前探测目标字符集是否被系统支持,避免运行时异常:
if (await CharsetConverter.checkAvailability('GBK')) {
  // ...安全编码
}
返回 Future<bool>,不存在或拼写错误的字符集名返回 false(不抛异常)。
5.4 availableCharsets:获取全部可用字符集
返回当前系统支持的全部字符集规范名列表,可用于调试或设置页展示:
final List<String> charsets = await CharsetConverter.availableCharsets();
// 鸿模拟器实测 232 项:['ISO-8859-1', 'UTF-8', 'GBK', ...]
不同平台返回的数量不同(各平台 ICU 数据裁剪差异),业务代码不要对数量做断言。
5.5 跨平台一套代码
适配采用"只做加法"策略,Dart 层零平台分支:上面四段代码在 Android、iOS、Linux、macOS、Windows、鸿蒙上行为一致,不需要写 Platform.isXxx 判断,同一份代码全平台编译运行。唯一需要留意的平台差异是字符集数量与替换字符语义,都汇总在第八节。
5.6 实战场景:对接只收 GBK 报文的下游系统
一个贴近业务的完整片段——应用要向一台只认 GBK 编码的工控/短信网关设备提交文本消息,提交前探测可用性、编码、并用 round-trip 保证没有信息丢失:
import 'dart:convert';
import 'dart:typed_data';
import 'package:charset_converter/charset_converter.dart';

class GbkGateway {
  /// 把用户文本编码为 GBK 报文;编码不了的信息不会静默丢失。
  static Future<Uint8List> buildPayload(String message) async {
    if (!await CharsetConverter.checkAvailability('GBK')) {
      throw const FormatException('当前设备不支持 GBK 编码');
    }

    final Uint8List payload = await CharsetConverter.encode('GBK', message);

    // round-trip 校验:GBK 编不了的字符(emoji、生僻字)会被替换填充,
    // 解回来与原文比对,不一致就上抛,由业务决定换 GB18030 或提示用户。
    final String roundTrip = await CharsetConverter.decode('GBK', payload);
    if (roundTrip != message) {
      throw FormatException('消息含 GBK 无法表示的字符,请改用 GB18030 或清理后重试');
    }
    return payload;
  }
}
调用处配合错误处理:
try {
  final Uint8List payload = await GbkGateway.buildPayload(textController.text);
  await gateway.send(payload);
} on FormatException catch (e) {
  showError(e.message);
} on PlatformException catch (e) {
  // 字符集名不被支持等底层错误,消息含 ICU 错误名
  showError('编码失败:${e.message}');
}
六、运行与验证
构建、安装、启动适配仓库 example 的完整命令序列:
git clone https://atomgit.com/oh-flutter/charset_converter.git
cd charset_converter/example
flutter pub get
flutter build hap --debug

# 安装并启动(先用 hdc list targets 确认设备在线)
hdc install -r build/ohos/hap/entry-default-signed.hap
hdc shell aa start -a EntryAbility -b com.example.demo
首次构建若只产出 intermediates 没有 HAP,是签名未配置:用 DevEco Studio 打开 example/ohos,在 File > Project Structure > Signing Configs 勾选 Automatically generate signature 后重新构建。
核心接口的验证步骤:启动后应用自动执行 13 项用例,从上往下滑动结果列表逐项核对。availableCharsets 与 checkAvailability 的结果在顶部统计卡(图一);10 组字符集 round-trip 逐条显示输入文本、编码后的字节数与 HEX 前缀、解码回环文本,中日韩部分见图二,全部显示 PASS 即为通过;错误处理用例对 definitely-not-a-charset 调用 encode,预期捕获到 CharsetConversionError 且应用不崩溃(图三)。
七、工作原理
理解通道链路,排查问题时有方向感。以 encode('GBK', '你好') 为例:
Dart  CharsetConverter.encode('GBK', '你好')
        │  MethodChannel('charset_converter')
        ▼
ArkTS  CharsetConverterPlugin.onMethodCall('encode')
        │  import charsetNative from 'libcharset_converter_ohos.so'
        ▼
C++    charsetEncode("GBK", "你好")          ← NAPI 原生模块
        │  ucnv_open("GBK") + ucnv_convertEx(UTF-8 → GBK)
        ▼
系统 ICU4C(libicu.so,系统自带,不占包体积)
        │  ArrayBuffer [0xC4 0xE3 0xBA 0xC3 ...]
        ▼
MethodChannel 回传 → Dart Future<Uint8List>
几个使用方常关心的点:其一,鸿蒙侧不用 ArkTS 的 util.TextEncoder 实现,因为它只支持 UTF-8,插件在 C++ 层调用系统 ICU4C 完成真实转换,这也是 availableCharsets 能返回 232 项的原因;其二,ICU 内置别名机制,字符集名大小写不敏感且 gb2312、cp1252 这类别名会自动解析到对应转换器;其三,失败会一路以 PlatformException(code CharsetConversionError)抛回 Dart,消息是 ICU 错误名,可直接查 ICU 文档定位。
八、常见问题
Q1:报 PlatformException,消息里有 U_FILE_ACCESS_ERROR,是文件权限问题吗?
不是。这是 ICU 对"打不开该转换器"的标准错误码,实际含义是字符集名不被支持或拼写有误。先用 checkAvailability 探测,或对照 availableCharsets 的规范名列表。
Q2:编码结果是替换字符"?"而不是报错,正常吗?
正常。ICU 对目标字符集表示不了的字符默认替换填充;上游 Linux 平台的 iconv 是直接报错,属于上游各平台本身的语义差异。不能接受信息丢失就用第五节 5.6 的 round-trip 校验兜底。
Q3:GBK 和 GB18030 怎么选?
GB18030 是 GBK 的超集,覆盖生僻字与 emoji;对端系统也认 GB18030 时优先用它,对端只认 GBK 时按 5.6 的方式校验并给出用户提示。
Q4:decode 出来是乱码但不报错?
ICU 会尽力转换而不替你判断"编错了",乱码说明字节来源的编码与传入的字符集名不一致。确认数据来源的编码声明,用 checkAvailability 排除拼写问题,必要时 round-trip 验证。
Q5:字符集名写法有什么讲究?
大小写不敏感,支持 ICU 别名:utf-8/UTF8、windows-1252/cp1252、gb2312 均可。规范名以 availableCharsets 返回的列表为准。
Q6:鸿蒙版会往包里塞编解码数据吗?
不会。转换用的是系统自带的 libicu.so,插件只带一个几十 KB 的桥接 .so(libcharset_converter_ohos.so),与上游"用平台自带能力"的设计一脉相承。
九、结语与相关链接
引入一个 git 依赖、四段与 Android/iOS 完全相同的代码,鸿蒙 App 就具备了 200+ 种字符集的编解码能力。使用中遇到适配层问题请到鸿蒙仓库 Issue 反馈,原库行为问题请到上游 Issue 反馈。想了解这套鸿蒙版是怎么做出来的,见姊妹篇《charset_converter 的鸿蒙适配教程》。
相关链接
欢迎加入 CPF-Flutter 鸿蒙社区,社区入口、环境搭建指南和本文相关链接统一放在这里:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献23条内容

所有评论(0)