
鸿蒙编辑器框架的文档模型:Block 树是唯一事实来源
一、"文档存在哪里"——一个值 855 行 RFC 的问题
先看反面教材。假设不做这个设计决策,让各子系统自行其是:
- 历史模块为了撤销方便,缓存了一份 Block 副本;
- 渲染层为了更新方便,维护了自己的块列表;
- 选区模块为了算上下文,存了光标所在块的引用。
现在用户敲了一个字符。请问:几处状态需要更新?答案是"不知道"——这正是分布式状态问题的定义。更糟的场景是撤销:用户看到的文档和撤销后恢复的文档不一致,因为两份副本中一份有 Bug。这类 Bug 的特征是静默:不崩溃、不报错,只是数据偶尔不对,复现依赖操作序列。
RFC-0001 用一句话终结了所有歧义:
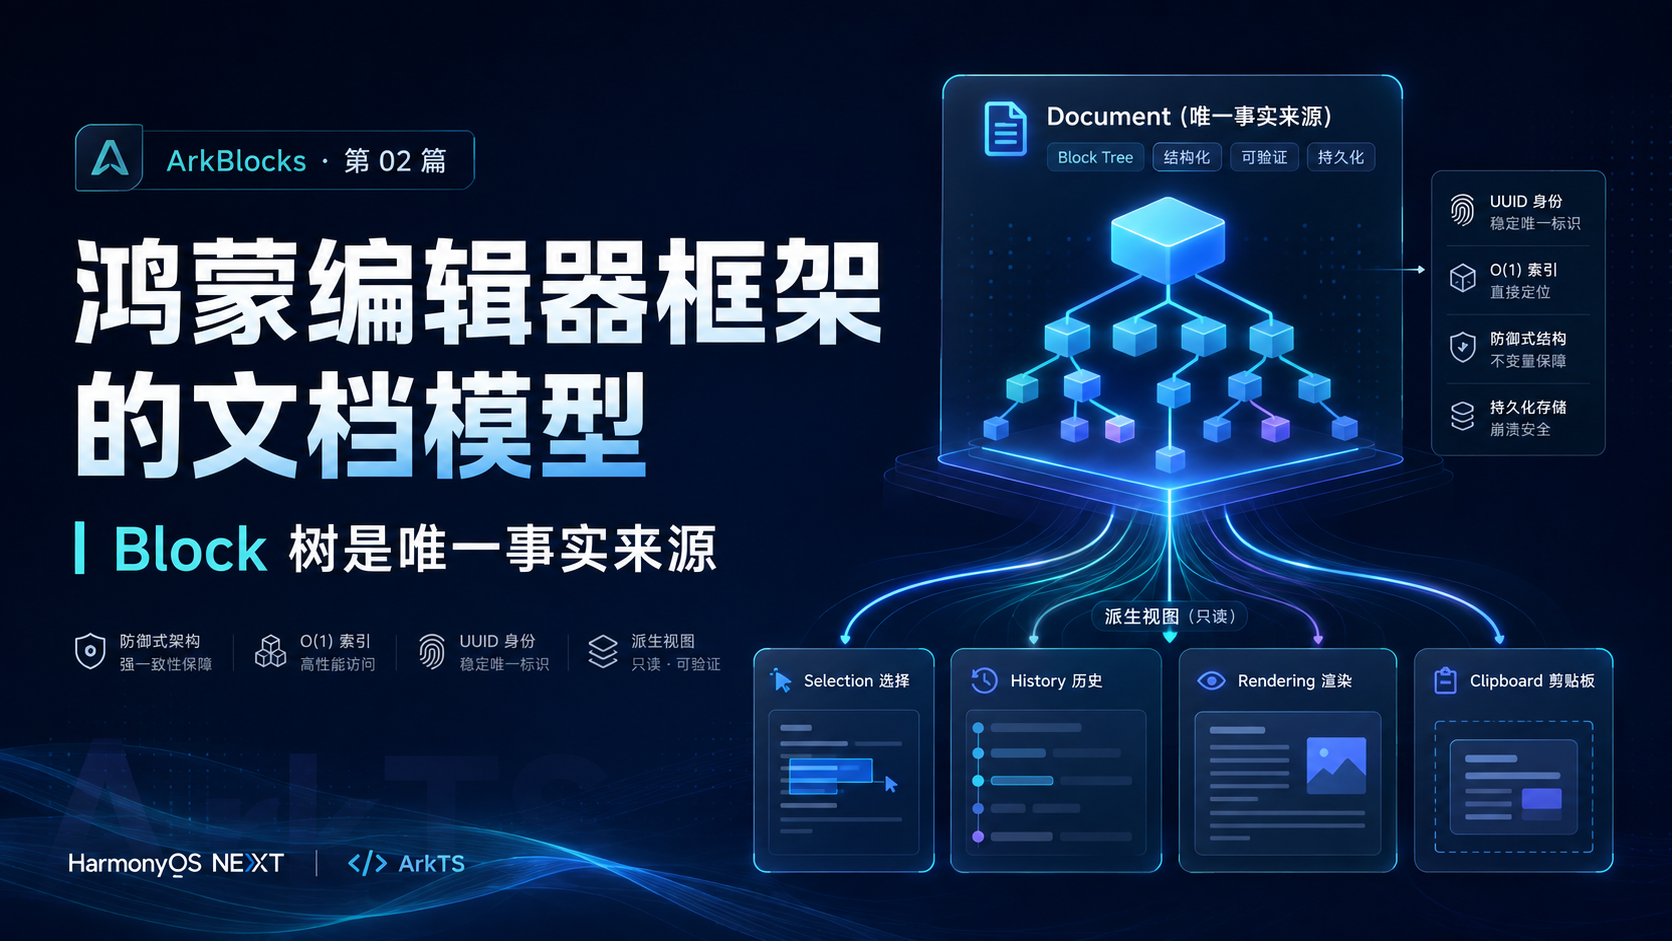
Document拥有 Block 树。Block 树是任何时刻编辑器内容的唯一权威表示。其他一切表示都是派生视图。
派生视图纪律随后被逐子系统写死:选区只存 (blockId, offset) 坐标,按需从 Document 解析上下文;历史只存操作逆序,从不存块内容;渲染器按需读取文档、观察事务提交;剪贴板只在复制时刻持有块快照;Markdown 模块只接收 Block[] 快照,连活的 Document 引用都不许拿。
这条原则的直接收益在测试上:Document 是纯逻辑模块,构造、变更、查询、序列化不需要任何渲染环境、不需要适配器、不需要真机。280 个规格测试里很大一部分就是这么跑的。
二、三个候选方案,为什么都毙了
定"Block 树为唯一事实来源"之前,RFC-0001 认真评估过三个替代方案,淘汰理由比方案本身更有营养:
| 方案 | 思路 | 淘汰理由 |
|---|---|---|
| ProseMirror 式双层表示 | 低层 node 树为准,应用层 Block API 是它的投影 | 需要维护双向转换层(BlockNote 里的 blockToNode / nodeToBlock),转换漂移是一整类 bug 的来源;ArkBlocks 没有 PM 历史包袱,没必要付这笔税 |
| 事件溯源(append-only 日志) | 只存操作序列,状态靠重放 | 大文档重放昂贵,任意时刻状态查询复杂;且事件溯源可以作为持久化策略叠在 Block 树之上,不必动本体 |
| 扁平 ID 映射 | Map<string, Block> + 显式父子引用 | 丢失天然顺序,有序遍历要额外记账;树才是层级内容的自然表示 |
注意第一条的措辞——不是"ProseMirror 不好",而是"它的双层表示是为浏览器环境和 PM 内核服务的,我们不必继承这个成本"。架构决策的对错从来是相对约束而言的。
三、三层数据模型解剖
真实类型定义(core/types/Block.ts,逐字引用):
export interface Block {
  /** 全局唯一、稳定。创建后永不改变。 */
  id: string;
  /** 块类型名。必须先在 SchemaRegistry 注册。 */
  type: string;
  /** 由 PropSchema 声明的类型化属性。 */
  props: Record<string, PropValue>;
  /** inline 模型块的行内内容;none / blocks 模型为 undefined。 */
  content: InlineContent[] | undefined;
  /** 嵌套子块。 */
  children: Block[];
}
第二层是行内内容的三型联合(core/types/InlineContent.ts):
export type InlineContent = StyledText | Link | CustomInline;

interface StyledText { type: 'text';  text: string; styles: Styles; }
interface Link       { type: 'link';  href: string; content: StyledText[]; }
interface CustomInline { type: string; props: Record<string, PropValue>; }
三个容易被忽略但极其要紧的设计细节:
细节一:content: undefined 和 content: [] 是两种状态。 分隔线、图片这类无内容块,content 必须是 undefined;段落类块的 content 是数组,哪怕空数组。这不是强迫症——内容模型(inline / none / blocks)是 BlockSpec 里的显式声明,校验器按声明执法(不变量 B5),"该没有内容的块有了内容"会被当成非法文档拒绝。类型层面就把两类块的边界表达清楚了。
细节二:Link 内嵌 StyledText[]。 链接文本自身可以带样式(加粗的链接),所以链接是一层小容器。这个决定在后面会回来找我们一次——深拷贝时它是唯一需要显式递归的行内类型(见第六节)。
细节三:PartialBlock 用于构造与补丁。 type 必填,其余可选,缺省由 Schema 补默认值。insert 一个块时应用只给半成品,框架负责凑齐——props 默认值不靠调用方记得。
四、Document 的真实实现:树 + 双 O(1) 索引
纯树结构按 ID 查块要 O(n) 遍历;纯 Map 结构又丢了兄弟顺序。Document 的答案是树存结构、索引加速查找,两个私有索引:
// document/Document.ts
export const ROOT_SENTINEL = '__root__';

export class Document {
  private root: Block[] = [];
  private readonly _blockIndex:  Map<string, Block>  = new Map(); // id → Block
  private readonly _parentIndex: Map<string, string> = new Map(); // id → 父 id | ROOT_SENTINEL
}
根级块的父 ID 存哨兵值 '__root__'——它不是合法 Block ID,永不与生成的 UUID 冲突,让 parentIndex 无需空值分支。查询复杂度:
| 操作 | 实现 | 复杂度 |
|---|---|---|
getBlock(id) | blockIndex 直查 | O(1) |
getParent(id) / getParentId(id) | parentIndex 直查 | O(1) |
getPath(id) | 沿 parentIndex 上爬 | O(d),d = 树深 |
getNextSibling / getPrevSibling | 父数组内定位 | O(k),k = 兄弟数 |
nextBlock(文档序后继) | 深度优先前序规则 | O(d) |
prevBlock(文档序前驱) | 取前兄弟最右最深后代 | O(d × s) |
nextBlock 是光标移动、查找、序列化遍历的基础,值得看它如何用 O(d) 做到不遍历全树(注释即规范,出自 SPEC-0001 §6.3):
// 文档序后继:1) 有孩子 → 首孩子;2) 有后兄弟 → 后兄弟;
// 3) 都没有 → 沿 parentIndex 上爬,找第一个有后兄弟的祖先
nextBlock(id: string): Block | null {
  const block = this._blockIndex.get(id);
  if (block === undefined) return null;
  if (block.children.length > 0) return block.children[0];      // 情形 1

  let currentId = id;
  while (true) {                                                 // 情形 2 & 3
    const parentId = this._parentIndex.get(currentId);
    if (parentId === undefined) return null;
    const siblings = parentId === ROOT_SENTINEL
      ? this.root : this._blockIndex.get(parentId)?.children ?? [];
    const idx = siblings.findIndex(b => b.id === currentId);
    if (idx !== -1 && idx + 1 < siblings.length) return siblings[idx + 1];
    if (parentId === ROOT_SENTINEL) return null;
    currentId = parentId;                                        // 继续上爬
  }
}
索引与树的同步是原子的:每次插块在同一个同步调用里完成 splice + indexSubtree,索引永不出现"落后于树"的中间态。插入时的索引构建是递归的,一个带子树的块进文档,整棵子树的映射一次建齐:
private indexSubtree(block: Block, parentId: string): void {
  if (this._blockIndex.has(block.id)) {
    throw new Error(`Block ID '${block.id}' already exists — violates [RFC S5]`);
  }
  this._blockIndex.set(block.id, block);
  this._parentIndex.set(block.id, parentId);
  for (const child of block.children) this.indexSubtree(child, block.id);
}
读接口同样设防:getRoot() 返回 root.slice() 浅拷贝(外部改不了根数组本身);两个索引只暴露 ReadonlyMap 视图,调用方拿得到 get/has/size,调不动 set/delete/clear。
五、变更通道:预检、快照、回滚
Document 的每个变更方法(insert / remove / move / update / duplicate / replace)都是同一个模子:先跑无副作用的 validateXxx() 预检,再动状态。预检失败返回描述性错误,文档一个字节不动:
insertBlock(block: Block, position: InsertPosition): string {
  const error = this.validateInsertBlock(block, position);  // 纯检查,零副作用
  if (error !== null) throw new Error(error);
  // ——以下才真正改状态——
  const { targetArray, insertIndex, parentId } = this.resolveInsertTarget(position);
  targetArray.splice(insertIndex, 0, block);
  this.indexSubtree(block, parentId);
  return block.id;
}
为什么这么执着于"先全查后全做"?因为调用它的事务管理器需要 all-or-nothing:一个事务里 N 个操作,必须全部合法才动手。预检方法就是为"在应用任何操作之前,把整批操作都验一遍"准备的。另外执行前还有一道保险——snapshot() 深拷贝整棵树,执行中途抛错就 restore() 回滚(这就是快照拷贝函数 deepCopyBlockForSnapshot 存在的原因)。
预检里藏着一组精确到不变量编号的错误信息,错误信息即文档:
// 校验删除:最后一个根块不许删(不变量 S1)
if (parentId === ROOT_SENTINEL && this.root.length === 1) {
  return `[DeleteBlock] Cannot delete the last root block — violates [RFC S1]`;
}
// 校验插入:ID 冲突(不变量 S5),连子树都要查
const childCollision = this.findIdCollisionInSubtree(block);
if (childCollision !== null) {
  return `[InsertBlock] Child block ID '${childCollision}' already exists — violates [RFC S5]`;
}
// 校验移动:不许把块挪进自己的子树(不变量 S4)
if (this.wouldCreateCycle(id, newParentId)) {
  return `[MoveBlock] Cannot move block '${id}' into its own subtree — violates [RFC S4]`;
}
环检测本身是 parentIndex 的漂亮应用——沿新父节点一路向上爬,O(d) 搞定,不需要全树遍历:
private wouldCreateCycle(blockId: string, newParentId: string): boolean {
  if (newParentId === ROOT_SENTINEL) return false;
  let current: string = newParentId;
  while (current !== ROOT_SENTINEL) {
    if (current === blockId) return true;          // 新父的祖先链上有自己 → 成环
    const next = this._parentIndex.get(current);
    if (next === undefined) {
      throw new Error(`parentIndex missing entry for '${current}' — index may be corrupted`);
    }
    current = next;
  }
  return false;
}
注意那个 throw:如果 parentIndex 半路断了,说明索引已经损坏——宁可炸出声,不带病运行。
六、三个防御性细节,每一个都对应真实 Bug
这节是本篇最值钱的部分。Document.ts 里三处看起来"过度谨慎"的代码,每处都对应一个评审编号——也就是说,都对应一个真实发生或差点发生的问题。
细节一:moveBlock 的 no-op 检测要用"删除后"的数组状态判断(CR-MAJOR-005)。
把块移到"它现在的位置",应当是无操作(不产生历史记录)。陷阱在于:移动 = 先 splice 删除、再 splice 插入,而删除动作会改变后续元素的下标。如果用删除前的下标判断"是不是原地",在向同数组前方插入的场景会误判。实现先删除、在删除后的数组上解析目标下标、再与原位置比对,宁多做一次 splice 也不引入索引错位。教训泛化:对"先删后插"式的移动,位置判断必须基于删除后的世界。
细节二:深拷贝必须显式处理 Link(CR-MAJOR-001)。
duplicateBlock 克隆块时要换新 ID,但这不是重点;重点是克隆后的副本不得与原件共享任何可变数组。逐型检查行内内容后发现一个漏网之鱼:StyledText 全是原始类型,spread 即可;CustomInline 的 props 值也是原始类型,spread 即可;唯独 Link.content: StyledText[] 是嵌套数组——spread 之后原副两个链接仍指向同一个数组,改一个坏一双:
function deepCopyInlineContent(ic: InlineContent): InlineContent {
  if (ic.type === 'link') {
    const link = ic as Link;
    return { type: 'link', href: link.href,
             content: link.content.map(r => ({ type: 'text', text: r.text, styles: { ...r.styles } })) };
  }
  if (ic.type === 'text') {
    const run = ic as StyledText;
    return { type: 'text', text: run.text, styles: { ...run.styles } };
  }
  return { ...ic } as InlineContent;
}
教训泛化:浅拷贝工具对嵌套结构的覆盖范围,要用类型联合逐项核对,不能靠"大概都是原始类型"。第三节埋的伏笔在这里兑现——Link 内嵌 StyledText[] 的设计没错,但每个享受这个设计的地方都要付深拷贝的成本。
细节三:reset 先全量预检、后清空(CR-MINOR-001)。
reset(blocks) 是反序列化入document的门户。朴素的写法是先清空两个索引再重建——但如果新数据里有重复 ID,清到一半发现非法,旧文档已经没了。实现用一整棵树扫描出所有 ID 做 Set 查重,确认合法后才 clear,失败时旧文档原封不动。和 snapshot/restore 一样,这是"输入不可信"前提下的标准姿势:先验证副本,再覆盖本体。
顺手一提,文件里还有一个 validateIndex():O(n) 遍历树,逐块核对索引指向、查重复出现、查孤儿节点,专供测试与调试断言用。给不变量配一个运行时验证器,是"文档永不为不一致状态"从口号变成可断言事实的关键一步。
七、UUID 的生死簿:身份规则为什么这么细
块的 id 是整个框架的锚点:光标挂在它上面、撤销要恢复它、渲染组件按它复用、评论与 AI 标注引用它。所以 RFC-0001 用一整节规定它的生死,核心规则浓缩成一张表:
| 事件 | ID 行为 | 为什么 |
|---|---|---|
| 内容/属性/类型变更 | 不变 | 改内容不是改身份 |
| 移动 / 嵌套 / 取消嵌套 | 不变 | 位置与深度不是身份 |
| 拆分(Enter) | 前块保留原 ID,新块新 UUID | 拆完是两个身份 |
| 合并(Backspace) | 幸存块保留,被吃掉的 ID 消亡 | 合并后只剩一个身份 |
| 撤销/重做 | 恢复原 ID | 外部引用(评论、AI 标注)必须继续有效 |
| 序列化/反序列化 | 原样带走、原样恢复 | 反序列化是"精确复原",不是"重新创建" |
| 复制→粘贴 / 克隆 | 每个粘贴块新 UUID | 剪贴板 ID 入文档必然撞车 |
最后一行落到代码上,就是第六节的 deepCopyWithNewIds:克隆即换 ID,子树逐块换。而拆分场景的对称要求更有意思——逆操作要能把文档恢复到与拆分前一模一样的 ID,所以拆分操作里的 newBlockId 由调用方预先分配,撤销时按原值恢复。ID 的生成被收拢到唯一的 IdGenerator,任何子系统不得私自造 ID。
一句话总结身份哲学:ID 跟着身份走,不跟着位置走;复制产生新身份,撤销复原旧身份。
八、不变量:文档的物理定律
RFC-0001 给 Document 定了两组必须永真的命题(此处摘主干):
结构组(S 系列):S1 根列表非空;S2 根不可被删空;S3 每块恰好出现在树的一个位置;S4 无环;S5 ID 全文档唯一;S6 无孤儿(每块都可从根到达);S7/S8 children 与 root 保序。
块级组(B 系列):B1 类型必须已注册;B2 props 必须符合 PropSchema(类型 + 取值白名单,未声明的 key 直接拒绝);B3 ID 创建后不可变;B5 内容模型与实际 content 匹配。
关键是执法点的分布:预检方法在变更前拦 S1/S4/S5/B5,indexSubtree 在写入时再拦 S5,validateIndex() 供测试后置全量核对。不变量不是写在文档里自我安慰的,每一层都有对应的代码在站岗。
九、序列化的边界:什么进 JSON,什么坚决不进
Document 的规范序列化目标就是 Block[] 本身——JSON 即文档,无损往返(内存态 A 序列化成 JSON 再还原成 C,A 与 C 结构完全一致,含全部 ID)。同样重要的是排除清单:
- 选区不序列化——它是交互状态,不是文档内容。文档该加载成什么样,与你上次光标在哪无关;
- 历史栈不序列化——撤销是会话产物,新加载的文档没有"过去"可撤销;序列化历史还会在操作格式演进时制造迁移灾难;
- 插件运行时状态默认不序列化——插件想持久化,走自己的存储。
这个"进与不进"的清单和第三节的 content model 一起,构成了文档格式的完整契约:将来云端同步、跨设备流转、协同合并,都建立在这个契约不变的前提上。
十、小结
把本篇压成五句话:
- 文档只存在一个地方——Document 的 Block 树;选区、历史、渲染、剪贴板全是派生视图,各存各的最小必需品。
- 树 + 双索引——树管结构与顺序,
blockIndex/parentIndex管查找;同步原子完成,索引对外只读。 - 先预检、后变更、留快照——无副作用校验 + 失败回滚,all-or-nothing 是数据层的肌肉记忆。
- ID 是身份,不是位置——内容变 ID 不变,复制粘贴必换新,撤销恢复旧值。
- 不变量层层设防——预检拦、写入拦、测试断言器兜底,文档永不为不一致状态。
这一层是整个框架的地基:正因为它纯粹(零平台依赖)、严谨(不变量执法)、可测(无渲染环境可跑),后面的事务引擎、撤销栈、渲染层才有资格"闭着眼睛信任它"。
下一篇:《鸿蒙编辑器框架的事务引擎:一切变更的唯一边界》——20 种类型化操作如何设计,两阶段提交(校验 → 快照 → 执行 → 回滚)怎么落地,以及为什么逆操作必须在"应用前"生成。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 18
 0
- 0


 已为社区贡献141条内容

所有评论(0)