
HarmonyOS | 鸿蒙服务分发指标体系:从曝光到任务完成
一、为什么这是鸿蒙新生态的关键能力
鸿蒙新生态里,服务分发不是把元服务、卡片或实况窗推给用户就结束。真正决定质量的,是开发者能不能回答三个问题:服务为什么在这个场景出现,用户看到后有没有完成任务,失败以后能不能定位到具体原因。如果文章只写“曝光、点击、转化”这些泛泛指标,就很难达到高质量技术博客的标准。
服务分发指标体系要服务于工程闭环。它既要看入口表现,也要看系统能力;既要看业务转化,也要看隐私、权限和打扰程度。HarmonyOS 的新生态能力强调多入口、多设备、多阶段协同,指标体系也必须能把负一屏、服务卡片、实况窗、通知、搜索、语音和应用页放到同一条链路里分析。
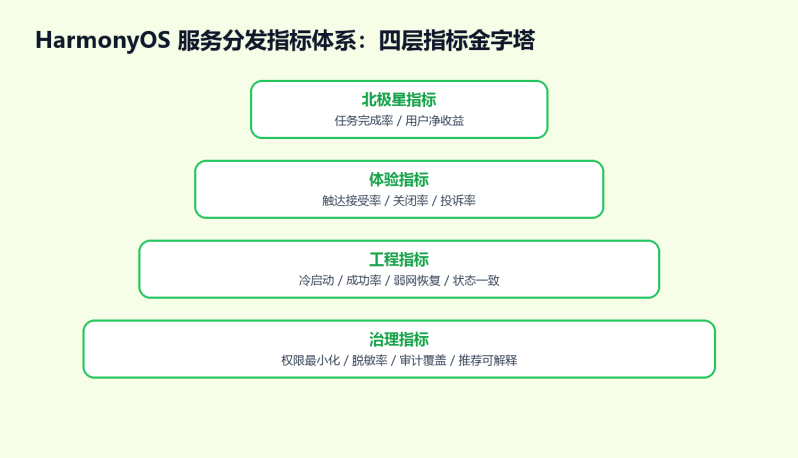
图 1 服务分发指标不是单点转化,而是四层质量体系
二、先定义北极星指标:任务完成率比点击率更重要
很多团队会把入口点击率当成分发效果,但这在鸿蒙服务生态中是不够的。服务入口越轻,用户越容易点进去;但如果启动慢、权限申请突兀、页面跳转复杂、跨端状态不一致,点击并不会变成真实完成。因此第一个核心指标应该是任务完成率。
任务完成率的分母不是全量用户,而是“被合理触达且表达出明确意图的用户”。比如报销审批元服务,用户在通知或卡片里点击“去审批”后,真正完成同意、驳回或转交才算完成。如果只统计进入页面,就会掩盖流程长、附件加载慢、身份校验失败等问题。
- 曝光指标回答:服务有没有出现在正确场景。
- 点击指标回答:入口文案和位置有没有吸引用户。
- 启动指标回答:用户是否顺利进入服务。
- 完成指标回答:服务是否真正解决任务。
- 复用指标回答:用户是否愿意下一次继续使用这个入口。
三、漏斗设计:把每一步都写成可观测事件
高质量指标体系一定要有事件模型。事件不是随便打 console,也不是每个页面各自埋点,而是用统一 traceId 串起一次服务分发的完整生命周期。一个用户可能先在负一屏看到服务,再从卡片进入,随后在实况窗查看进度,最后在应用页完成确认。如果没有统一 traceId,这些行为会被拆成几段孤立数据。
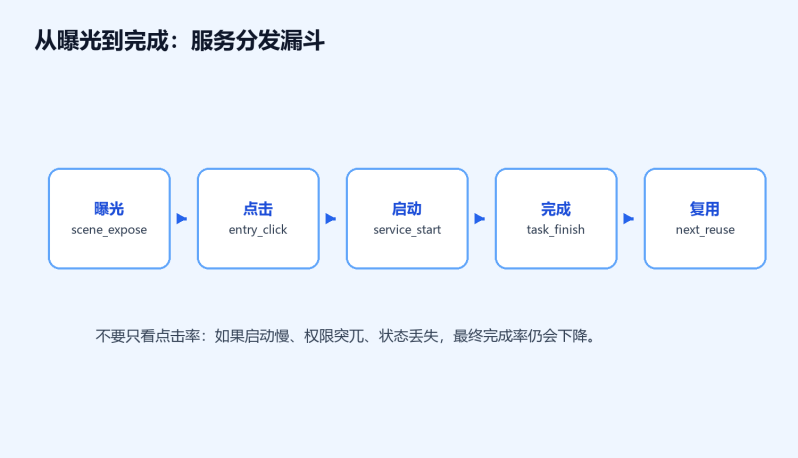
图 2 从曝光到复用的服务分发漏斗
// ArkTS 示例:服务分发漏斗事件模型
type EntryType = 'minusOne' | 'card' | 'liveView' | 'notification' | 'search' | 'voice'
type EventName = 'scene_expose' | 'entry_click' | 'service_start' | 'task_finish' | 'task_fail' | 'entry_close'
interface DistributionEvent {
traceId: string
serviceId: string
entry: EntryType
event: EventName
scene: string
deviceType: 'phone' | 'tablet' | 'car' | 'watch' | 'screen'
costMs?: number
reasonCode?: string
ts: number
}
function reportEvent(event: DistributionEvent) {
const safePayload = {
...event,
// 不上传姓名、手机号、地址、订单明细等敏感原文
ts: Date.now()
}
console.info('[distribution-event]', JSON.stringify(safePayload))
}
四、指标分层:业务、体验、工程、治理缺一不可
服务分发指标不能只交给运营同学看。业务层看完成率和复用率;体验层看关闭率、投诉率、二次打开率;工程层看冷启动、接口成功率、弱网恢复率、跨端状态一致率;治理层看权限拒绝率、脱敏覆盖率、审计完整率。四层指标合起来,才能判断一个鸿蒙元服务是否值得继续扩大分发。
|
指标 |
计算方式 |
业务含义 |
异常处理 |
|
曝光命中率 |
有效曝光 / 场景触发 |
判断是否在正确时机出现 |
低于 40% 先排查场景规则 |
|
任务完成率 |
完成任务 / 点击入口 |
判断服务是否真正解决问题 |
低于 60% 检查流程和性能 |
|
关闭率 |
关闭推荐 / 曝光 |
判断是否打扰用户 |
高于 12% 降频或换入口 |
|
弱网恢复率 |
恢复成功 / 弱网失败 |
判断服务韧性 |
低于 95% 增加重试队列 |
|
权限拒绝率 |
拒绝授权 / 权限请求 |
判断授权时机和文案 |
高于 8% 延迟申请权限 |
五、多入口归因:不要让负一屏、卡片和实况窗互相抢功
鸿蒙新生态的复杂点在于入口很多。用户可能在负一屏首次看到服务,在通知里点击,在实况窗里持续查看,最后从应用页完成任务。如果把最后一次点击全部归功给应用页,就会低估前置入口价值;如果把首次曝光全部归功给负一屏,又会高估低质量曝光。因此需要设计多触点归因。
比较稳妥的做法是给一次任务建立 traceId,并记录 firstTouch、lastTouch 和 assistTouch。firstTouch 用来判断哪个入口发现需求,lastTouch 用来判断哪个入口促成完成,assistTouch 用来判断中间状态更新是否减少了用户焦虑。这样既能优化入口,也能优化任务链路。
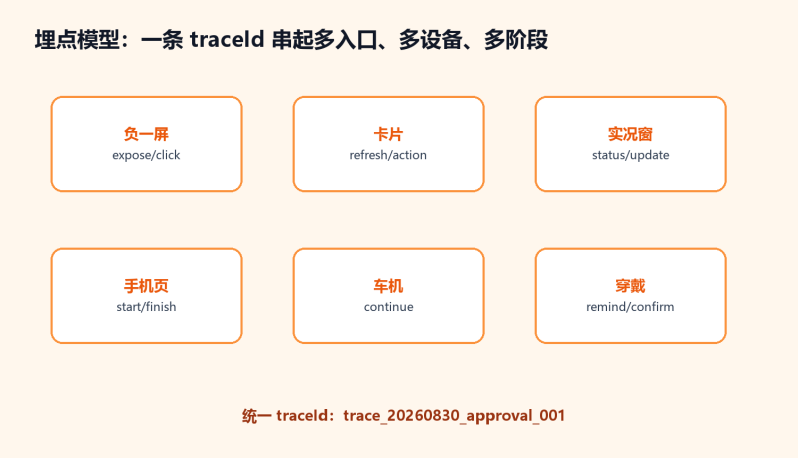
图 3 用 traceId 连接多入口行为
interface Attribution {
traceId: string
firstTouch?: EntryType
lastTouch?: EntryType
assistTouch: EntryType[]
}
function updateAttribution(attr: Attribution, entry: EntryType, event: EventName): Attribution {
if (event === 'scene_expose' && !attr.firstTouch) {
attr.firstTouch = entry
}
if (event === 'task_finish') {
attr.lastTouch = entry
}
if (!attr.assistTouch.includes(entry)) {
attr.assistTouch.push(entry)
}
return attr
}
六、异常归因:点击高但完成低,问题通常不在标题
当一篇文章写到指标体系时,必须进一步写异常归因。比如点击率高但完成率低,常见原因包括冷启动慢、权限时机不对、服务状态丢失、跨端接续失败、表单字段太多、弱网没有重试。此时继续优化标题和卡片样式只能带来表面增长,真正应该排查的是完成链路。
- 曝光低:场景识别规则太窄,或服务没有被绑定到合适入口。
- 点击低:标题、理由、按钮动作不清晰,用户不知道点了能做什么。
- 启动低:冷启动、账号校验、权限申请或网络握手拖慢了首屏。
- 完成低:流程过长、状态不一致、失败不可恢复或需要重复输入。
- 关闭高:推荐时机不准、频率过高、推荐理由不透明。
interface FunnelStat {
expose: number
click: number
start: number
finish: number
close: number
}
function diagnose(stat: FunnelStat): string[] {
const result: string[] = []
const clickRate = stat.click / Math.max(stat.expose, 1)
const finishRate = stat.finish / Math.max(stat.click, 1)
const closeRate = stat.close / Math.max(stat.expose, 1)
if (clickRate < 0.12) result.push('入口文案或推荐场景需要优化')
if (finishRate < 0.6) result.push('完成链路存在阻塞,优先检查启动、权限和状态')
if (closeRate > 0.12) result.push('用户打扰感偏强,需要降频或解释推荐理由')
return result
}
七、A/B 实验:验证入口,不要拍脑袋改分发策略
服务分发策略不能凭感觉上线。比如同一个审批服务,A 方案放在通知里,B 方案放在服务卡片里,C 方案只在工作时间展示。到底哪个更好,不应只看点击率,而要比较任务完成率、平均完成时长、关闭率和权限拒绝率。
A/B 实验还要注意样本一致性。不要把活跃用户放进 A 组,把新用户放进 B 组;不要在节假日和工作日混算;不要在一个实验里同时改入口、文案、按钮和流程,否则无法知道是哪一个因素产生影响。
八、质量看板:让指标能指导下一步动作
指标体系最终要落到看板和动作。如果看板只展示数字,没有阈值、趋势、归因和负责人,就很难推动优化。建议每个服务建立一张轻量质量看板,至少包含指标、阈值、异常信号和处理动作。这样开发、产品、运营和审核都能围绕同一组事实协同。
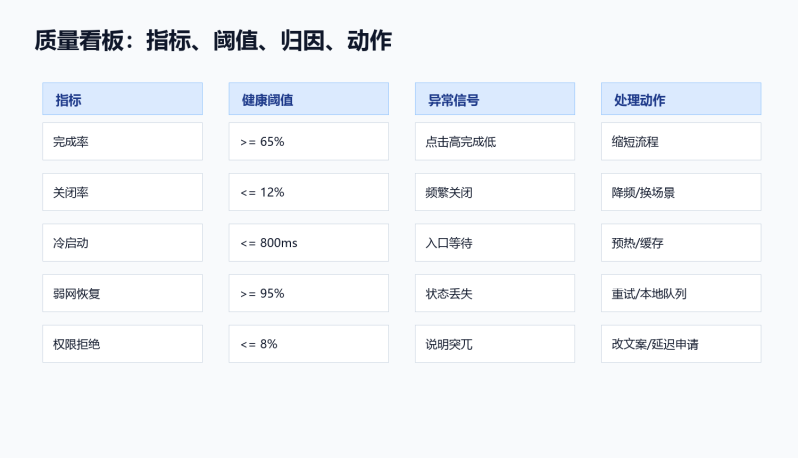
图 4 服务质量看板需要同时覆盖指标和动作
九、CSDN 高质量写法:这类文章要怎么写才像实战
写 HarmonyOS 服务分发指标体系,不能只列“曝光、点击、转化”三个词。更好的结构是:先讲为什么点击率不够,再画出漏斗,再给事件模型代码,然后讨论多入口归因、异常诊断和实验方法,最后给出质量看板。这样读者不仅知道概念,还能把文章内容迁移到真实项目。
- 标题要包含 HarmonyOS、鸿蒙、服务分发、指标体系等检索词。
- 正文要有图:指标金字塔、分发漏斗、traceId 链路、质量看板。
- 正文要有代码:事件模型、归因模型、漏斗诊断、实验配置。
- 正文要有边界:隐私脱敏、权限最小化、用户关闭入口和审计。
- 结尾要有落地建议:先做一个服务的完整漏斗,再扩大到多入口。
十、指标口径设计:先把“算什么”说清楚
指标体系最怕口径不一致。产品同学说完成率是点击后的完成,运营同学说完成率是曝光后的完成,开发同学又按接口成功率统计,最后三张报表都对,但没有一张能指导决策。HarmonyOS 服务分发场景里,一个服务可能从负一屏曝光,在卡片点击,在实况窗更新,在应用页完成,因此必须先约定每个指标的分母、分子、去重方式和时间窗口。
推荐把口径写进代码配置,而不是只写在需求文档里。这样埋点 SDK、离线计算、实时看板和实验平台都能复用同一份定义。比如“任务完成率”的分母可以是 entry_click,分子可以是 task_finish,窗口可以是 30 分钟,去重维度可以是 traceId。只要口径固定,团队就能持续比较不同版本、不同入口、不同设备上的效果。
// ArkTS 示例:把指标口径配置化,避免报表各算各的
type MetricName = 'exposeRate' | 'clickRate' | 'startRate' | 'finishRate' | 'closeRate'
interface MetricDefinition {
name: MetricName
numerator: EventName
denominator: EventName
dedupeBy: 'traceId' | 'userId' | 'deviceId'
windowMinutes: number
description: string
}
const metricDefinitions: MetricDefinition[] = [
{
name: 'clickRate',
numerator: 'entry_click',
denominator: 'scene_expose',
dedupeBy: 'traceId',
windowMinutes: 30,
description: '判断入口文案和触达时机是否有效'
},
{
name: 'finishRate',
numerator: 'task_finish',
denominator: 'entry_click',
dedupeBy: 'traceId',
windowMinutes: 60,
description: '判断服务是否真正帮助用户完成任务'
}
]
function findMetricDefinition(name: MetricName): MetricDefinition | undefined {
return metricDefinitions.find(item => item.name === name)
}
十一、埋点 SDK 设计:业务方只报动作,公共层补齐上下文
如果每个业务页面都手写完整埋点,很快就会出现字段遗漏、命名不一致和隐私风险。更好的做法是封装一个轻量埋点 SDK:业务方只传 serviceId、event 和必要参数,公共层自动补齐 traceId、entry、deviceType、版本号、网络状态和时间戳。这样既降低接入成本,也能保证后续分析的数据结构稳定。
在 HarmonyOS 多入口场景里,公共层尤其重要。因为同一服务可能从卡片、通知、实况窗、语音、搜索进入,业务代码不应该关心入口细节。入口层在创建 traceId 时写入 source,业务层只关心任务是否启动、是否完成、是否失败。这样文章里的代码就能体现真实工程分层,而不是一段孤立示例。
// ArkTS 示例:服务分发埋点 SDK
interface TrackContext {
traceId: string
entry: EntryType
deviceType: 'phone' | 'tablet' | 'car' | 'watch' | 'screen'
appVersion: string
network: 'wifi' | 'cellular' | 'offline' | 'unknown'
}
interface TrackOptions {
serviceId: string
event: EventName
scene: string
costMs?: number
reasonCode?: string
}
class DistributionTracker {
private context: TrackContext
constructor(context: TrackContext) {
this.context = context
}
track(options: TrackOptions) {
reportEvent({
traceId: this.context.traceId,
serviceId: options.serviceId,
entry: this.context.entry,
event: options.event,
scene: options.scene,
deviceType: this.context.deviceType,
costMs: options.costMs,
reasonCode: options.reasonCode,
ts: Date.now()
})
}
}
const tracker = new DistributionTracker({
traceId: 'trace_approval_20260831_001',
entry: 'card',
deviceType: 'phone',
appVersion: '1.2.0',
network: 'wifi'
})
tracker.track({
serviceId: 'approval.expense',
event: 'service_start',
scene: 'office_approval'
})
十二、上报队列:弱网和跨端场景不能丢事件
服务分发指标经常在弱网、切后台、设备切换时失真。比如用户在地铁里点击卡片,网络抖动导致 entry_click 没上报,但 task_finish 在恢复网络后上报成功,报表就会出现完成数大于点击数的异常。要避免这种问题,需要本地队列、重试策略和幂等 ID。
事件队列不需要复杂到像消息中间件,但要具备三个基本能力:失败后落本地、恢复网络后批量上报、服务端按 eventId 幂等去重。对于隐私字段,队列里也不能保存原文,只保存脱敏后的 reasonCode、sceneCode 和 traceId。
// ArkTS 示例:简化版本地事件队列
interface QueuedEvent extends DistributionEvent {
eventId: string
retryCount: number
}
class EventQueue {
private queue: QueuedEvent[] = []
enqueue(event: DistributionEvent) {
this.queue.push({
...event,
eventId: `${event.traceId}_${event.event}_${event.ts}`,
retryCount: 0
})
}
async flush(sender: (events: QueuedEvent[]) => Promise<boolean>) {
if (this.queue.length === 0) return
const batch = this.queue.slice(0, 20)
const success = await sender(batch)
if (success) {
this.queue = this.queue.slice(batch.length)
return
}
this.queue = this.queue.map(item => ({
...item,
retryCount: item.retryCount + 1
})).filter(item => item.retryCount <= 3)
}
}
const queue = new EventQueue()
queue.enqueue({
traceId: 'trace_001',
serviceId: 'approval.expense',
entry: 'card',
event: 'entry_click',
scene: 'office_approval',
deviceType: 'phone',
ts: Date.now()
})
十三、看板聚合:从事件流计算可读指标
有了事件并不等于有了指标。事件是原始事实,指标是面向决策的聚合结果。比如一次服务链路中可能出现多次 expose、多次 status update 和一次 finish,如果直接按事件条数统计,就会高估曝光和中间状态。聚合时应该以 traceId 去重,并按时间窗口识别同一次任务。
下面的示例展示如何把事件流聚合成漏斗数据。真实项目可以在服务端、离线任务或本地调试工具里实现同样逻辑。写进文章的价值在于:读者能清楚看到指标不是凭空出现的,而是由事件模型、去重规则和窗口规则共同计算出来。
// TypeScript 示例:从事件流聚合漏斗
interface FunnelResult {
expose: number
click: number
start: number
finish: number
fail: number
close: number
}
function aggregateFunnel(events: DistributionEvent[]): FunnelResult {
const traces = new Map<string, Set<EventName>>()
for (const event of events) {
if (!traces.has(event.traceId)) {
traces.set(event.traceId, new Set<EventName>())
}
traces.get(event.traceId)!.add(event.event)
}
const result: FunnelResult = {
expose: 0,
click: 0,
start: 0,
finish: 0,
fail: 0,
close: 0
}
for (const set of traces.values()) {
if (set.has('scene_expose')) result.expose++
if (set.has('entry_click')) result.click++
if (set.has('service_start')) result.start++
if (set.has('task_finish')) result.finish++
if (set.has('task_fail')) result.fail++
if (set.has('entry_close')) result.close++
}
return result
}
十四、实验配置:一次只验证一个核心变量
A/B 实验章节也要写代码,否则容易变成方法论空话。服务分发实验至少要包含实验 ID、分桶规则、入口策略、目标指标、护栏指标和结束条件。目标指标负责判断收益,护栏指标负责防止副作用。比如 B 组完成率提升了,但关闭率和投诉率也明显升高,就不能直接全量。
实验还要避免多个变量同时变化。假设 A 组使用卡片入口,B 组使用通知入口,同时 B 组还改了标题、按钮和流程,那么完成率提升后无法判断到底是入口变化带来的,还是文案变化带来的。高质量文章要提醒读者:实验不是随便切流量,而是一套可复盘的工程流程。
// ArkTS/TypeScript 示例:服务分发 A/B 实验配置
interface ExperimentConfig {
experimentId: string
serviceId: string
bucket: 'A' | 'B'
entryPolicy: {
entry: EntryType
maxExposePerDay: number
quietHours: [number, number]
}
targetMetric: MetricName
guardMetrics: MetricName[]
stopRule: {
minSample: number
maxCloseRate: number
minFinishRateLift: number
}
}
const experimentB: ExperimentConfig = {
experimentId: 'exp_approval_card_vs_notification',
serviceId: 'approval.expense',
bucket: 'B',
entryPolicy: {
entry: 'card',
maxExposePerDay: 2,
quietHours: [22, 7]
},
targetMetric: 'finishRate',
guardMetrics: ['closeRate', 'startRate'],
stopRule: {
minSample: 5000,
maxCloseRate: 0.12,
minFinishRateLift: 0.05
}
}
十五、落地建议:先做单服务闭环,再扩展多入口
如果团队刚开始做 HarmonyOS 服务分发指标体系,不建议一开始就覆盖所有服务。更合理的路径是先选一个高频、边界清晰、状态可验证的服务,例如审批、排队、物流、挂号或会员权益提醒。先把这个服务的曝光、点击、启动、完成、失败、关闭全部打通,再复制到更多服务。
第一阶段先统一事件模型和 traceId;第二阶段补齐本地队列和失败重试;第三阶段建立基础漏斗看板;第四阶段加入多入口归因;第五阶段再做实验平台和自动诊断。这个顺序能避免团队过早陷入复杂平台建设,也能让文章读者看到一条现实可落地的路线。
十六、常见问题:为什么指标看起来正常,用户仍然觉得不好用
服务分发还有一个容易被忽略的问题:指标正常不代表体验一定好。比如完成率很高,可能是因为只有强需求用户才会点击;关闭率很低,可能是因为关闭入口隐藏太深;冷启动达标,可能是因为首屏先展示骨架屏,但关键数据很久才回来。因此,指标体系不能只看单点数值,还要看用户路径、异常样本和真实反馈。
在 CSDN 技术文章里,写到这里就能体现作者是否真的懂落地。不要只给出公式,还要解释公式什么时候会误导团队。比如曝光命中率高但投诉率也高,说明推荐规则可能太激进;完成率高但复用率低,说明用户只是被迫完成一次任务,并没有认可这个入口;弱网恢复率高但平均恢复时长很长,说明用户虽然最终成功,但等待体验仍然不达标。
- 不要用单一指标判断服务质量,至少同时看完成率、关闭率和异常恢复。
- 不要把低关闭率直接理解为用户满意,要确认关闭入口是否清晰可见。
- 不要只看平均值,长尾耗时、失败重试次数和跨端状态冲突更能暴露问题。
- 不要把埋点写成隐私风险,敏感信息必须用枚举、哈希或 reasonCode 替代。
// TypeScript 示例:把健康检查结果转成优化建议
interface HealthSnapshot {
clickRate: number
finishRate: number
closeRate: number
p95StartCostMs: number
weakNetworkRecoverRate: number
permissionRejectRate: number
}
function buildActionList(snapshot: HealthSnapshot): string[] {
const actions: string[] = []
if (snapshot.clickRate < 0.12) {
actions.push('重写入口标题和推荐理由,补充用户下一步收益')
}
if (snapshot.finishRate < 0.6) {
actions.push('排查完成链路,重点检查权限申请、表单字段和失败兜底')
}
if (snapshot.closeRate > 0.12) {
actions.push('降低曝光频率,增加稍后提醒和不再推荐入口')
}
if (snapshot.p95StartCostMs > 1200) {
actions.push('优化冷启动,提前加载关键数据或延迟非核心模块')
}
if (snapshot.weakNetworkRecoverRate < 0.95) {
actions.push('增加本地队列、幂等重试和状态恢复提示')
}
if (snapshot.permissionRejectRate > 0.08) {
actions.push('调整权限申请时机,把授权说明放到用户动作之后')
}
return actions
}
十七、发布前自检:让文章更容易被判为高质量
最后从内容发布角度看,这篇文章要想更像高质量 CSDN 稿,应该具备五个信号。第一,标题能被搜索到,包含 HarmonyOS、鸿蒙、服务分发、指标体系等关键词;第二,正文有真实工程问题,不只是宣传式描述;第三,代码能表达模型和流程;第四,图片能解释架构、漏斗、归因和看板;第五,结尾能给开发者一条可执行路径。
如果读者是 HarmonyOS 开发者,他读完应该能拿走三件东西:一份可复用的事件模型、一套指标口径设计方法、一条从单服务到多入口的落地路线。如果读者是产品或运营,他也能理解为什么不能只盯点击率,而要从任务完成、打扰治理、弱网恢复和权限拒绝等角度判断服务质量。这样的文章既有技术细节,也有业务判断,更符合平台对原创技术内容的期待。
十八、总结
HarmonyOS 服务分发指标体系的核心,不是统计多少人看到了入口,而是判断服务有没有在正确场景帮助用户完成任务。高质量指标体系必须同时覆盖业务效果、用户体验、工程稳定性和隐私治理。只有这样,开发者才能知道一个元服务该扩大分发、降低频率、优化流程,还是暂停推荐。
对开发者来说,指标不是上线后的附属工作,而是服务设计的一部分。入口如何出现、状态如何同步、失败如何恢复、权限如何解释、数据如何脱敏,都应该在指标体系里留下可观察信号。这样的文章才更接近真实工程,也更容易达到 CSDN 高质量技术内容的标准。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 6
 0
- 0


 已为社区贡献27条内容

所有评论(0)